Bigtable: A Distributed Storage System for Structured Data
TL;DR
Motivation
為了解決 petabyte等級的資料,設計出來的side applicability, scability, high performance和high availiability的distributed storage system。
Data Model
bigtable只要是一個由row key, column key和timestamp為key組成的sorted map。
(row:string, column:string, time:int64) -> string
Rows
Rows根據row key被partitioned,而且row是lexicographic ordered。
Column Families
最小的access單位,access control做在這個level。
Building Blocks
GFS
Log和data被存在GFS上。
Chubby
Chubby是google的distributed lock service,用來決定master和tablet server是否還在使用某個tablet。
SSTable & Memtable
Bigtable本身的資料結構主要使用SSTable和Memtable。如果有一筆操作來就寫入Memtable,Memtable到一定size就輸出成一個SSTable檔案,SSTable是immutable,所以不用擔心lock問題,因為是read only。
Implementation
Tablet Location
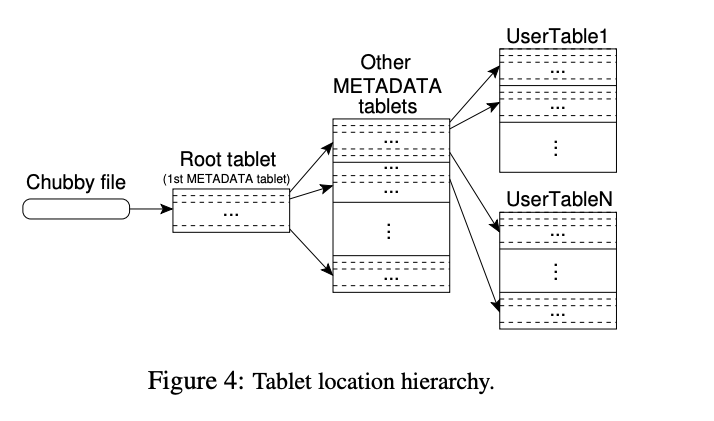 每個bitable都是3層的 的結構,第一層在Chubby存著root tablet,root table裡面存的是所有metadata tablets,
Metadata存的是哪個row key存在哪個tablet的資訊。
Tablet Assignment
每個tablet會被assign給一個tablet server,tablet server會在Chubbycreate一個file,代表自己own這個tablet。
Master會定期檢查這些file,如果tablet server掛了或是因為網路原因導致無法繼續lock tablet,master就會把這個檔案刪掉,代表釋放tablet server不在負責這個tablet,而tablet server檢查到檔案被刪以後,也會知道自己不在負責,會釋出tablet。
如果tablet成長的太大,master會負責sharding,但不管怎樣一定會保持3層的 。
Tablet Serving
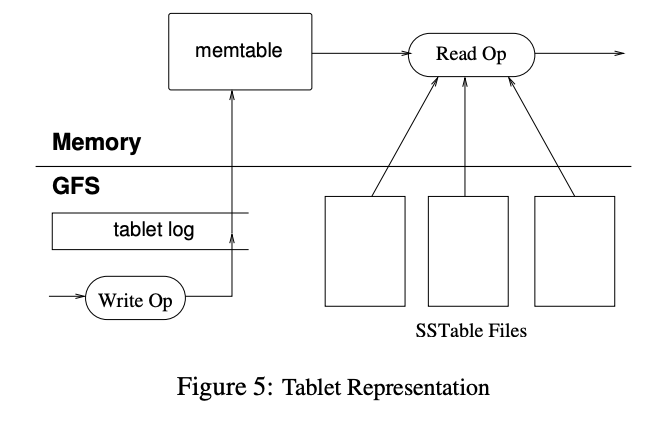 如圖所示,當write request到
tablet server,會把操作寫到log,並且把結果寫到Memtable,tablet server並且會做snapshot,在failover的時候,才不需要replay太多操作。
而read request就Memtable或是SSTable來處理。
Compactions
當Memtable超過Threshold,就會create一個新的Memtable,並且把舊的output成SSTable,此過程稱為minor compaction。
為了減少SSTable的數目,tablet server會定時的做merging compaction把Memtable和幾個SSTable合在一起,減少total的SSTable數目。
Minor compaction和merging compaction產出的SSTable都含有deletion(thumbstone)的log,因此還會執行major compaction,major compaction的SSTable不包含deletion (thumbstone)的log,會釋放出更多資源。
Refinement
Locality Groups
Bigtable允許把column families定義在同一個locality group,因此這些資料可以被一起存取,改善performance。
Compression
Client可以指定SSTable block要不要被加密。Bigtable做2-pass的加密,first pass是Bentley and McIlory's scheme,second pass是一個fast compress algorithm,經過2-pass的compression,可以達到10-1的reduction。
Caching
為了改善讀取效能,tablet server有兩層的cache:scan cache和block cache。Scan cache cache SSTable回傳的key-value pair,block cache cache SSTable的block。
Bloom Filters
Tablet server會先用Bloom Filter檢查 key是否存在SSTable,存在才嘗試在SSTable中找尋。
Commit-log
為了減少所有commit log的檔案數目,commit log不是以tablet為單位,而是以tablet server為單位,每個tablet server保存一份commit log file。
但是這樣會造成recover的時候的複雜度,為了改善recovery的速度,這些commit log被根據<table, row name, sequence number>的排序方式group在一起,在recover的時候,就可以快速的redo某個tablet的commit log。